30분짜리 사내 세션을 열었다
회사 디자이너들이 Figma MCP를 쓰기 시작하면서 이런 말들이 들렸다. "이게 어떻게 되는 건지 모르겠어요." "그냥 되는 건지 알았는데 갑자기 안 되더라고요." "토큰이 뭐예요?" 툴은 쓰고 있는데 안에서 무슨 일이 벌어지는지 모르는 상태는 생각보다 불편하다. 잘 될 때는 그냥 넘어가고, 안 될 때는 어디를 손봐야 할지 모른다.
처음 AI를 쓸 때 뭘 시켜야 할지, 뭘 물어야 답이 나오는지 몰라서 한참 막연했다. 그 막연함을 조금이라도 걷어내고 싶어서 짧게 30분짜리 세션을 하나 열었다.
목표는 세 가지로 잡았다.
- AI에 대한 막연한 두려움 걷어내기
- 프롬프트가 왜 먹히고 왜 안 먹히는지, 동작 원리를 짧게라도 이해하기
- Figma MCP를 쓸 때 내부에서 어떤 일이 일어나는지 감 잡기
세션에서 다룬 내용
일단 오해부터 풀고 시작했다
AI가 '자아를 가진 무언가'처럼 느껴지는 건 자연스러운 반응이다. 하지만 개념 자체는 꽤 오래됐다.
1950년대에 앨런 튜링이 튜링 테스트를 제안했다. 컴퓨터가 사람처럼 대화할 수 있는지 구별하는 실험이었다. 당시 수준은 "강아지는 무슨 소리를 내나요?"에 "멍멍"이라고 답하는 정도, 정해진 룰대로 답을 돌려주는 시스템이었다.
지금의 AI도 결국 주어진 질문에 정해진 방식으로 답을 계산하는 시스템이다.
왜 갑자기 붐이 됐을까
1950년대 이후로는 오랫동안 정체기였다. 하드웨어 성능도 데이터 저장 용량도 부족해서 컨셉만 있고 진도가 안 나갔다.
2010년대에 두 가지가 바뀐다. 첫째는 데이터다. SNS가 커지면서 사람들이 텍스트와 이미지를 폭발적으로 올리기 시작했고, AI를 학습시킬 재료가 생겼다. 둘째는 컴퓨팅 파워, GPU가 좋아졌다.
그리고 2017년에 구글이 Transformer 아키텍처를 발표한다. 텍스트 자동완성 같은 작업을 훨씬 빠르고 효율적으로 처리하는 방법이었다.
2022년에 OpenAI가 그걸 일상적인 Q&A 상황에 맞게 다듬어 내놓은 게 ChatGPT다. 없던 기술이 하루아침에 나타난 게 아니라, 오래 쌓인 기술이 이제야 대중화된 셈이다.
결국은 확률 계산이다
AI는 다음에 올 단어의 확률을 계산한다.
"프랑스의 수도는 어디인가요?"라고 물으면 "파리입니다"가 가장 확률이 높은 다음 단어라서 그렇게 답한다.
"고양이가 어디에 있나요?"라고 물으면 내부에서는 대략 이런 계산이 돌아간다.
- 박스 안: 80%
- 나무 위: 10%
- 방 안: 5%
- 기타: 5%
그래서 "박스 안에 있습니다"가 나온다.
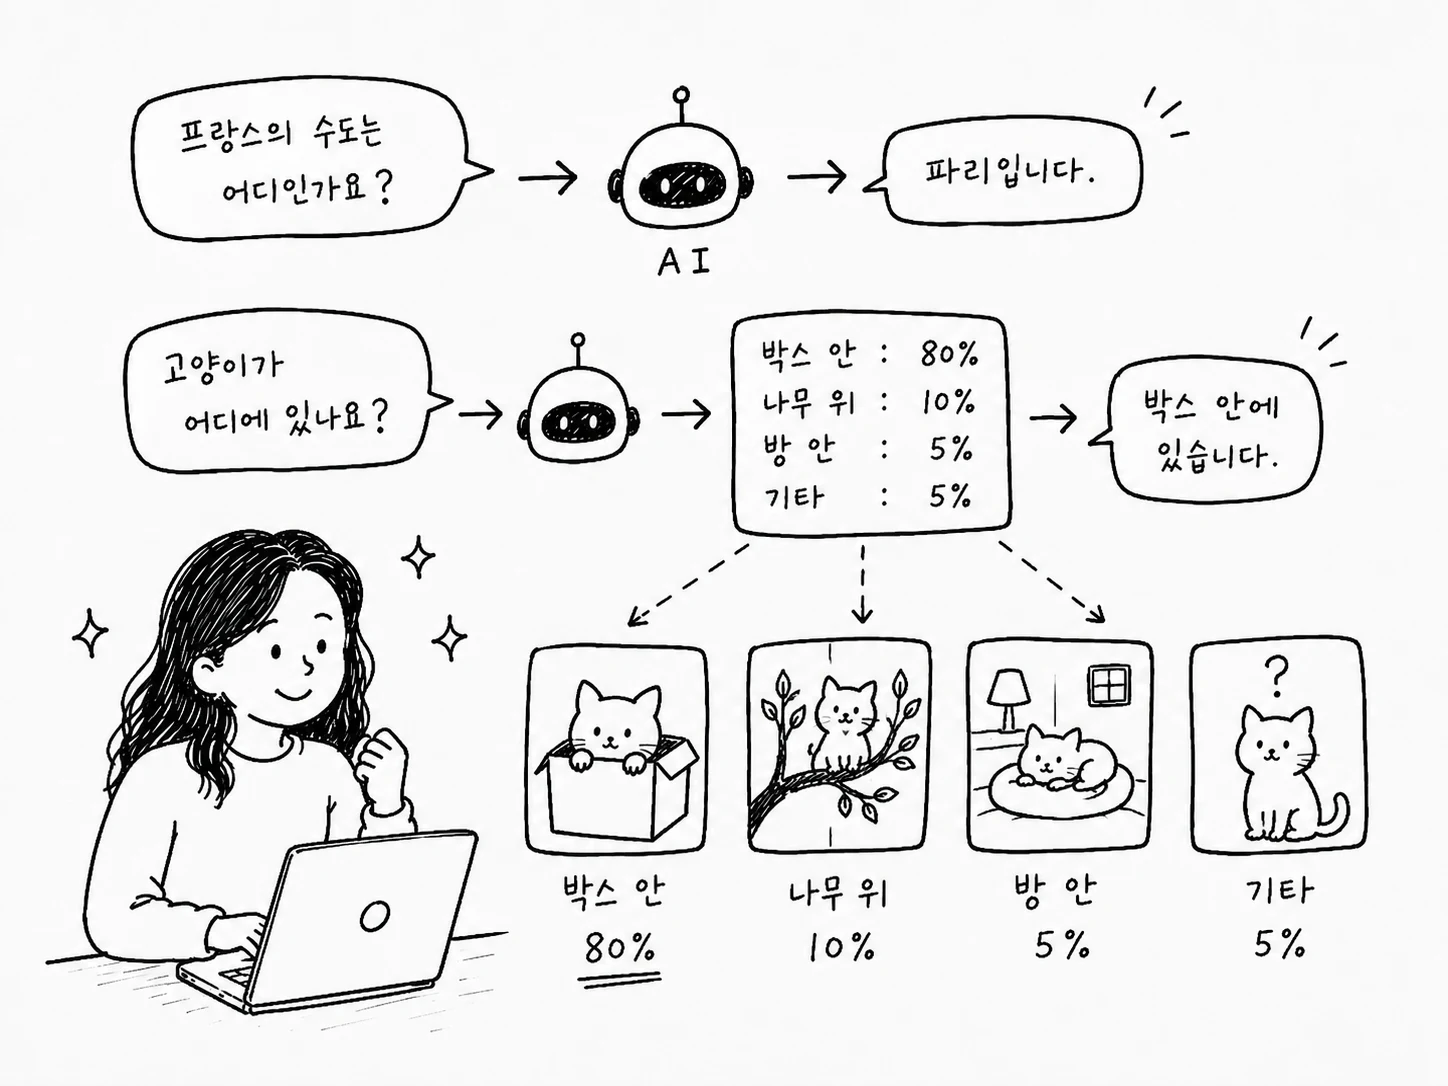
예측이 기막히게 잘 맞는 이유는 인터넷 규모의 데이터를 학습했기 때문이다. 자아가 생겼다기보다는 성능이 아주 좋은 자동완성에 가깝다.
맥락을 주면 토큰이 줄어든다
뭔가를 물어볼 때 범위를 좁혀주면 예측이 훨씬 정확해진다.
"내 피그마 파일 어디 있어?"라고 하면 AI는 컴퓨터 전체를 뒤져야 하고, 그만큼 토큰을 많이 쓴다. "데스크탑 어딘가에 있을 거야"라고 한 줄 붙여주면 범위가 좁아지면서 토큰은 줄고 정확도는 올라간다.
memory.md, claude.md 같은 파일이 하는 일이 이거다. AI가 작업을 시작하기 전에 먼저 읽고 가는 맥락 문서다. 프롬프트 엔지니어링이 유행한 이유도 비슷하다. 맥락을 잘 설계하면 토큰을 덜 쓰면서 더 좋은 답이 나온다.
Claude와 Claude Code는 뭐가 다른가
많이 헷갈리는 부분이다.
Claude(claude.ai)는 브라우저에서 채팅으로 쓰는 버전이다. 텍스트 응답, 문서 작업, 라이팅에 강하다. 대신 터미널을 제어하거나 내 컴퓨터의 파일을 직접 고치지는 못한다.
Claude Code는 터미널에서 돌아가는 AI 에이전트다. 같은 모델을 쓰지만 할 수 있는 일이 더 많다.
- 터미널 제어
- 컴퓨터 내 파일 접근 및 수정
- JSON 생성 및 실행
- MCP로 외부 툴 호출
Figma MCP는 Claude Code가 있어야 작동한다. claude.ai에서는 안 된다.
Figma MCP가 하는 일
AI 모델 자체는 텍스트를 예측할 뿐이라 Figma를 직접 건드릴 수단이 없다. 그래서 MCP(Model Context Protocol)가 사이에 낀다.
Claude Code ↔ MCP ↔ Figma
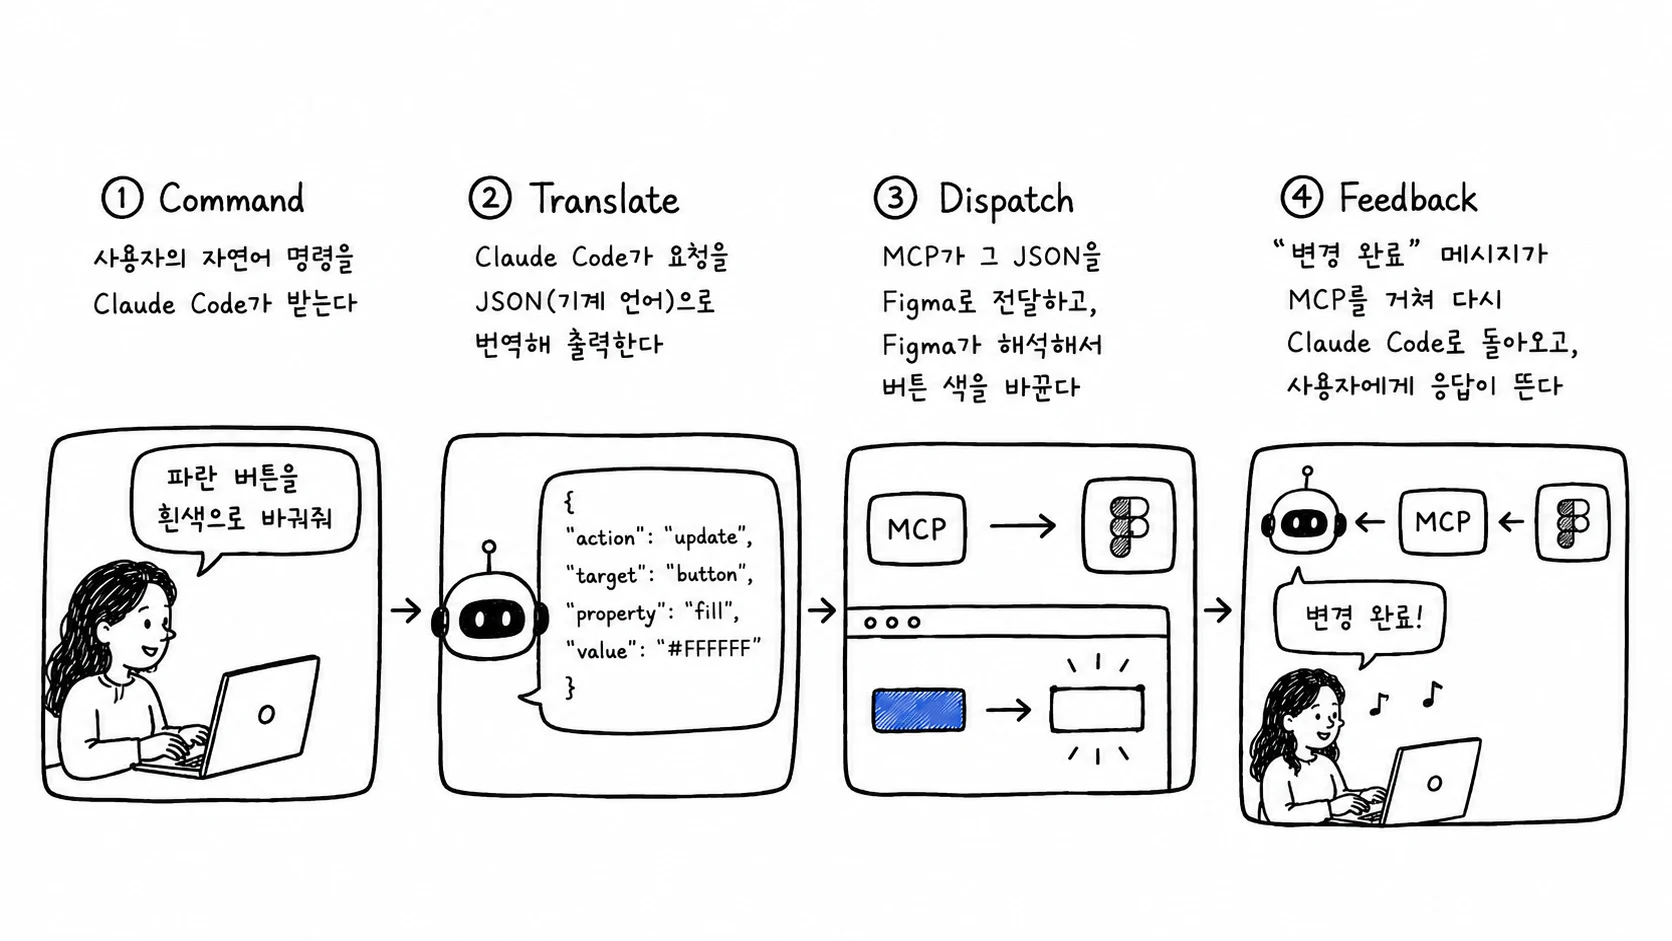
MCP는 둘 사이에서 말을 옮겨주는 역할을 한다. "파란 버튼을 흰색으로 바꿔줘"라고 하면 실제로는 이런 순서로 진행된다.
- Command — 사용자의 자연어 명령을 Claude Code가 받는다
- Translate — Claude Code가 요청을 JSON(기계 언어)으로 번역해 출력한다
- Dispatch — MCP가 그 JSON을 Figma로 전달하고, Figma가 해석해서 버튼 색을 바꾼다
- Feedback — "변경 완료" 메시지가 MCP를 거쳐 다시 Claude Code로 돌아오고, 사용자에게 응답이 뜬다
MCP와 Skill은 다르다
MCP는 외부 툴과 직접 소통하는 중간다리다. Figma 같은 외부 시스템을 실제로 호출한다.
Skill(skill.md)은 중간다리가 아니라 AI가 작업 전에 먼저 읽는 텍스트 문서, 일종의 매뉴얼이다. Skill 안에 "필요하면 Figma MCP 써줘"라고 적어두면 그때 MCP가 호출되는 식으로 같이 쓰는 경우가 많다.
Skill은 길어질수록 토큰을 많이 먹으니 꼭 필요한 맥락만 담는 게 좋다.
디자이너가 당장 해볼 세 가지
01. 자동완성이라고 생각하기. 아주 똑똑한 자동완성 기계라는 전제로 프롬프트를 짜면 기대치도 요청도 훨씬 현실적으로 잡힌다.
02. 맥락, 타게팅, 태스크 쪼개기. MD 파일로 맥락을 주고, 범위를 좁혀 타게팅하고, 큰 작업은 작은 단위로 자른다. 결과물 품질은 대부분 여기서 갈린다.
03. 한 번에 너무 많이 시키지 않기. "화면 10장 넘게 그려줘"라고 하면 텍스트가 과하게 생성되고, 토큰을 초과해서 MCP에 닿기도 전에 실패한다.
세션을 끝내고 나서
Figma MCP 세팅법 자체는 Claude에게 "피그마 MCP 연결 방법 알려줘"라고 물어보는 게 제일 빠르고 정확하다. 웹서치와 최신 문서를 조합해서 답하기 때문에 구글링보다 낫다.
세션에서 일부러 반복한 말이 하나 있다.
AI는 신이 아닙니다. 하지만 맥락을 잘 주면 정말 똑똑해져요.
원리를 알고 나면 "왜 이게 안 되는 거지?"라는 질문이 "아, 맥락이 부족했구나"로 바뀐다. 걷어내고 싶었던 건 그 막연함이었다.