가상 유저 패널(synthetic user panel)을 직접 만들어 실무에 쓰면서 합성 패널에 관심이 생겼다. 그래서 관련 연구와 강연을 찾아 읽었고, 그 내용을 AI와 함께 정리했다.
우선 합성 유저란 무엇인가
델프트 공과대학의 Gu, Chandrasegaran & Lloyd(2025)는 실제 데이터를 바탕으로 하되 부족한 부분을 합성 데이터로 채운 페르소나를 합성 유저(Synthetic User)라고 부르자고 제안한다. 기존 페르소나가 읽기만 하는 문서였다면, 합성 유저는 질문을 던지면 답을 하는 가상의 대화 상대다.
Salminen, Amin, Jung & Jansen(2025)에 따르면 현업에서 합성 유저를 쓰는 사례는 늘고 있다. 개인정보 규제 때문에 실제 유저를 만나기 어려워진 경우도 있고, 유저 리서치가 얼마나 성과를 냈는지 숫자로 증명하기 어렵다는 사정도 있다. 무엇보다 실제 참여자를 모집하려면 돈이 든다. 조직은 돈이 덜 드는 쪽을 고르게 마련이다.
리서치 데이터 없이 만든 합성 유저의 문제
LLM은 학습한 데이터의 패턴을 조합하는 도구라서 그 바깥의 이야기는 잘 만들지 못한다. 누군가의 구체적인 경험 대신 어디서 본 듯한 일반적인 유저 묘사가 나온다. 게다가 합성 유저는 말을 워낙 잘해서, 내용이 부실해도 오히려 더 믿음직해 보인다. 틀리는 것보다 곤란한 건 틀린 티가 안 난다는 점이다. Salminen 등(2025)이 꼽는 위험 중 하나가 이 그럴듯한(하지만 사실과는 다른) 모방이다.
같은 지적을 실무 쪽에서 가장 구체적으로 한 건 Nielsen Norman Group의 Rosala & Moran(2024)이다. 합성 유저는 상대를 만족시키려는 성향이 있어서 실제보다 우호적인 답을 내놓는다. 무엇이든 다 중요하다고 답하는 탓에 니즈는 잔뜩 나오지만 무엇을 먼저 해결해야 할 문제인지는 가려지지 않는다. 행동 데이터는 애초에 존재할 수 없다. 게다가 합성 유저의 답은 우리가 통제할 수 없는 인터넷 데이터에서 학습한 것이라 어떤 편향이 섞여 있는지 알기 어렵다.
그럼 정확도를 어떻게 높이는가
정확도를 끌어올렸다고 보고하는 연구들은 하나같이 실제 사람에게서 나온 자료를 깔고 시작한다. 나이나 직업 같은 속성을 목록으로 늘어놓는 대신, 그 사람의 이야기(narrative)를 길게 넣어주는 쪽이다.
Kang 등(2025)의 Deep Binding이 그렇다. 속성을 나열하는 대신, 여러 차례에 걸쳐 진행한 인터뷰 기록을 그대로 배경 이야기로 넣어준다. 사람의 성격은 자기 이야기를 통해 만들어진다는 이론(서사 정체성)을 설계에 가져온 것이다. 저자들은 정치 성향 설문에서 응답 분포를 따라가는 정확도가 87% 나아졌다고 보고한다.
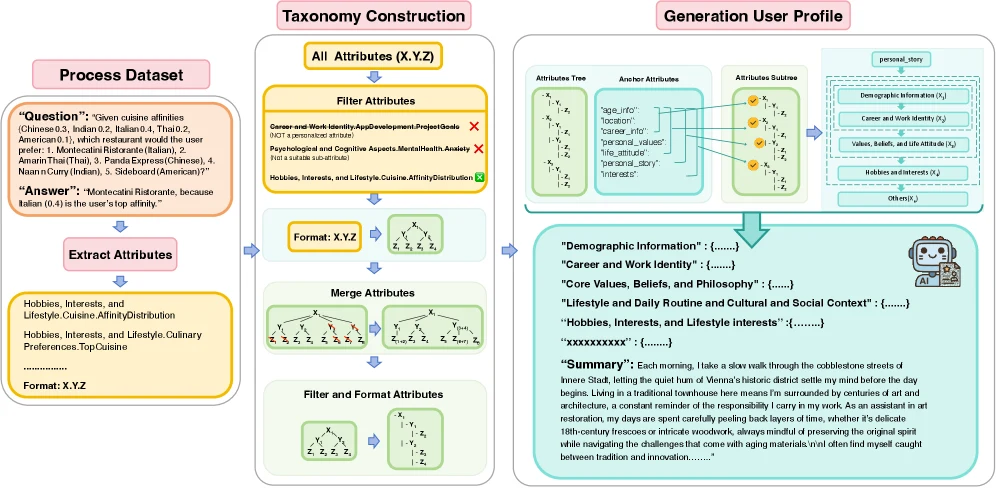
DeepPersona(2025)는 두 방식을 같이 쓴다. 페르소나 하나에 정리된 속성 수백 개와 1MB 남짓의 설명 글을 함께 담는다. 기존 방식보다 속성 다양성이 32%, 프로필 고유성이 44% 나아졌고, 사회 조사에서 흉내낸 응답과 실제 응답의 차이를 31.7% 줄였다고 한다.
여기서 말하는 정확도란 무엇일까. 사람에게 실제로 물었던 설문을 페르소나에게 똑같이 물어보고 두 답이 얼마나 일치하는지를 재는 것이 일반적이다. 그러니까 이 방식은 정답지 역할을 하는 사람의 답이 시간이 지나도 변하지 않는다는 전제를 깔고 있다. 그 전제가 맞는지 확인해본 연구가 있다.
Park 등(2024)은 미국 성인 1,052명에게 2시간짜리 인터뷰와 설문(General Social Survey, Big Five)을 진행했다. 그리고 2주 뒤 같은 설문을 한 번 더 해서, 같은 사람이 2주 전 자기 답을 얼마나 지키는지부터 쟀다. 1차 데이터로 만든 에이전트에게도 같은 문항을 물었다.
General Social Survey 문항에서 참가자가 2주 뒤 자기 응답을 그대로 유지한 비율은 79.53%였고, 인터뷰 기록으로 만든 에이전트가 참가자의 응답을 맞힌 비율은 65.67%였다. 여기서 눈에 띄는 건 같은 사람에게 같은 걸 물어도 2주 만에 답의 20%가 바뀐다는 사실이다. 바뀌는 정도는 문항에 따라 다르다. Big Five 문항에서는 1차와 2차 응답의 상관계수가 0.95로 훨씬 안정적이었다. 그래서 저자들은 사람의 답을 정답지로 쓰려면 그 정답지가 얼마나 흔들리는 문항인지도 같이 봐야 한다며, 에이전트의 정확도를 '에이전트가 참가자 응답을 맞힌 비율 ÷ 사람이 자기 응답을 유지한 비율'로 보정해서 봐야 한다고 주장한다.
합성 유저의 정확도를 높이기 위해 사람 데이터를 한 번 모으고 마는 게 아니라 계속 모으는 쪽으로 설계한 연구도 있다. Romberg 등(2026)의 하이브리드 패널은 한 패널 안에 사람 응답자와 LLM을 같이 두고, 조사를 한 차례 돌 때마다 양쪽 답이 어긋난 지점을 찾아 다음 차례에 모델을 고친다. LLM이 대신 만든 응답이 말이 되는지 사람이 검토하는 절차도 함께 둔다.
그렇다면 무엇까지 물어볼 수 있는가
아무리 정확도를 올려도 그것은 결국 특정한 맥락 안에서의 정확도다. Anand(2026)의 강연은 합성 패널을 일기예보에 빗대어 설명한다. 일기예보는 정해진 조건 안에서는 잘 맞지만 그 범위를 벗어나면 틀린다. 합성 페르소나도 학습한 데이터가 닿는 범위 안에서만 쓸 만하다.
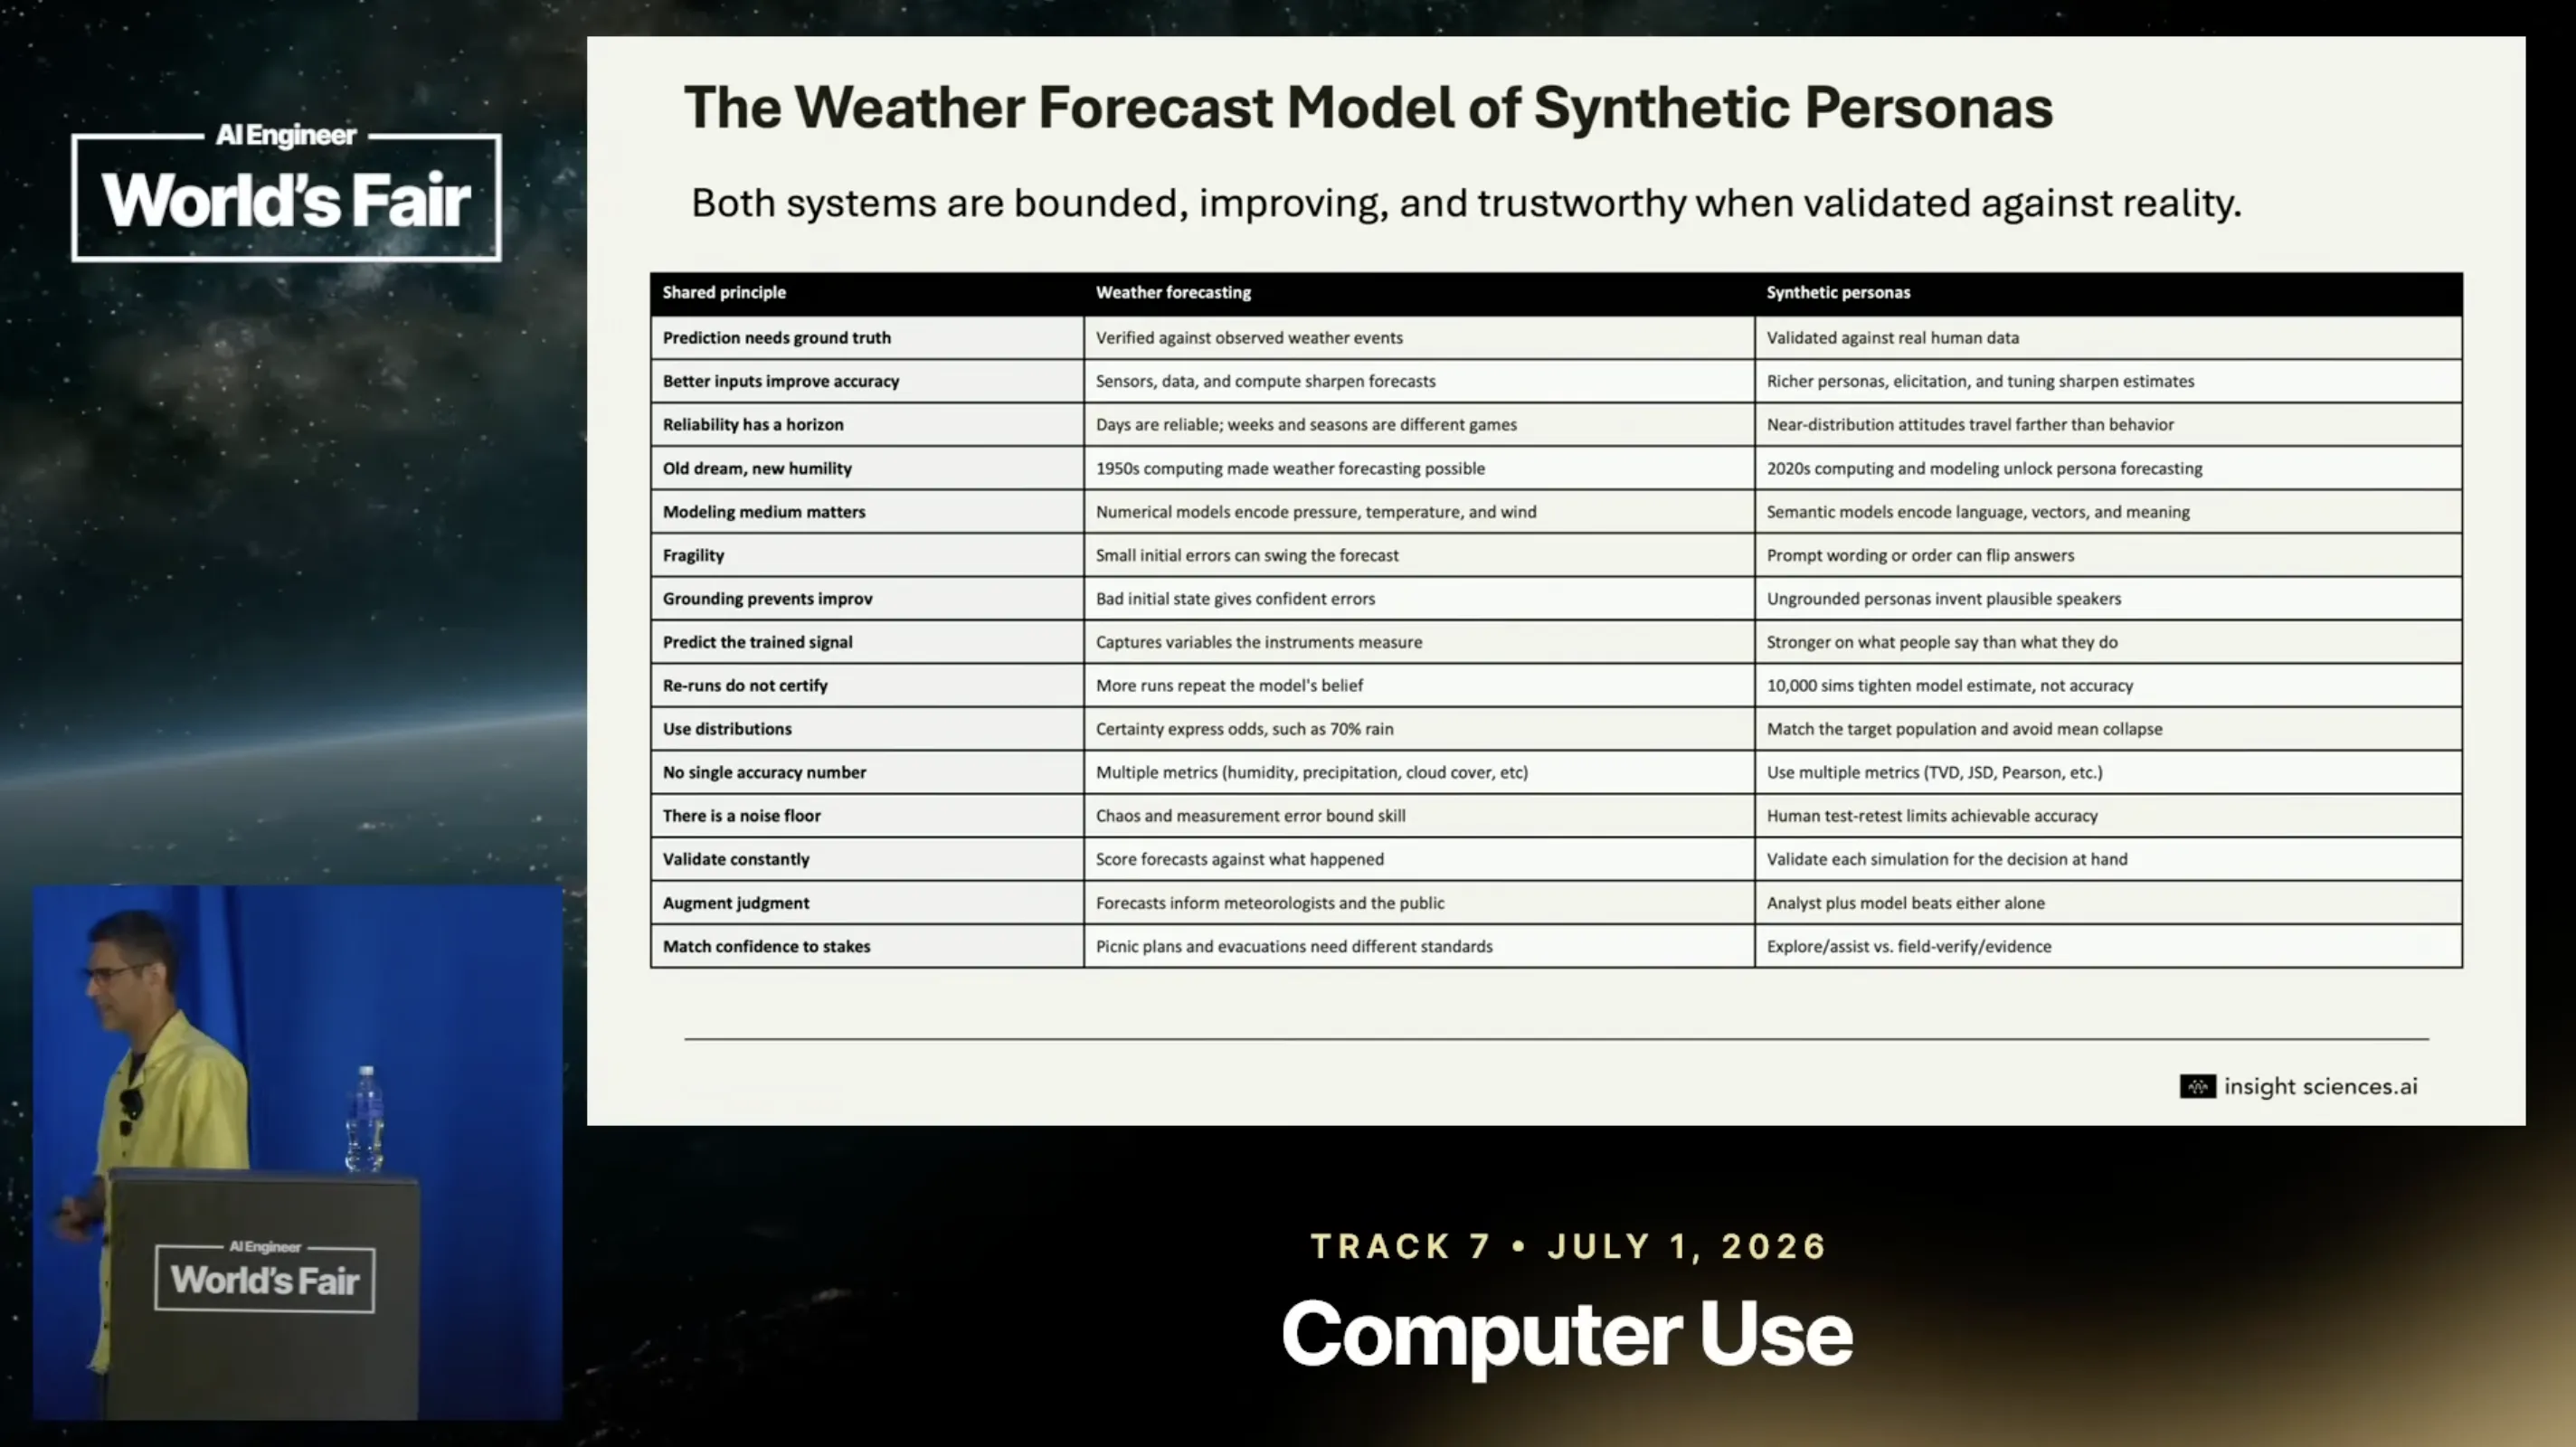
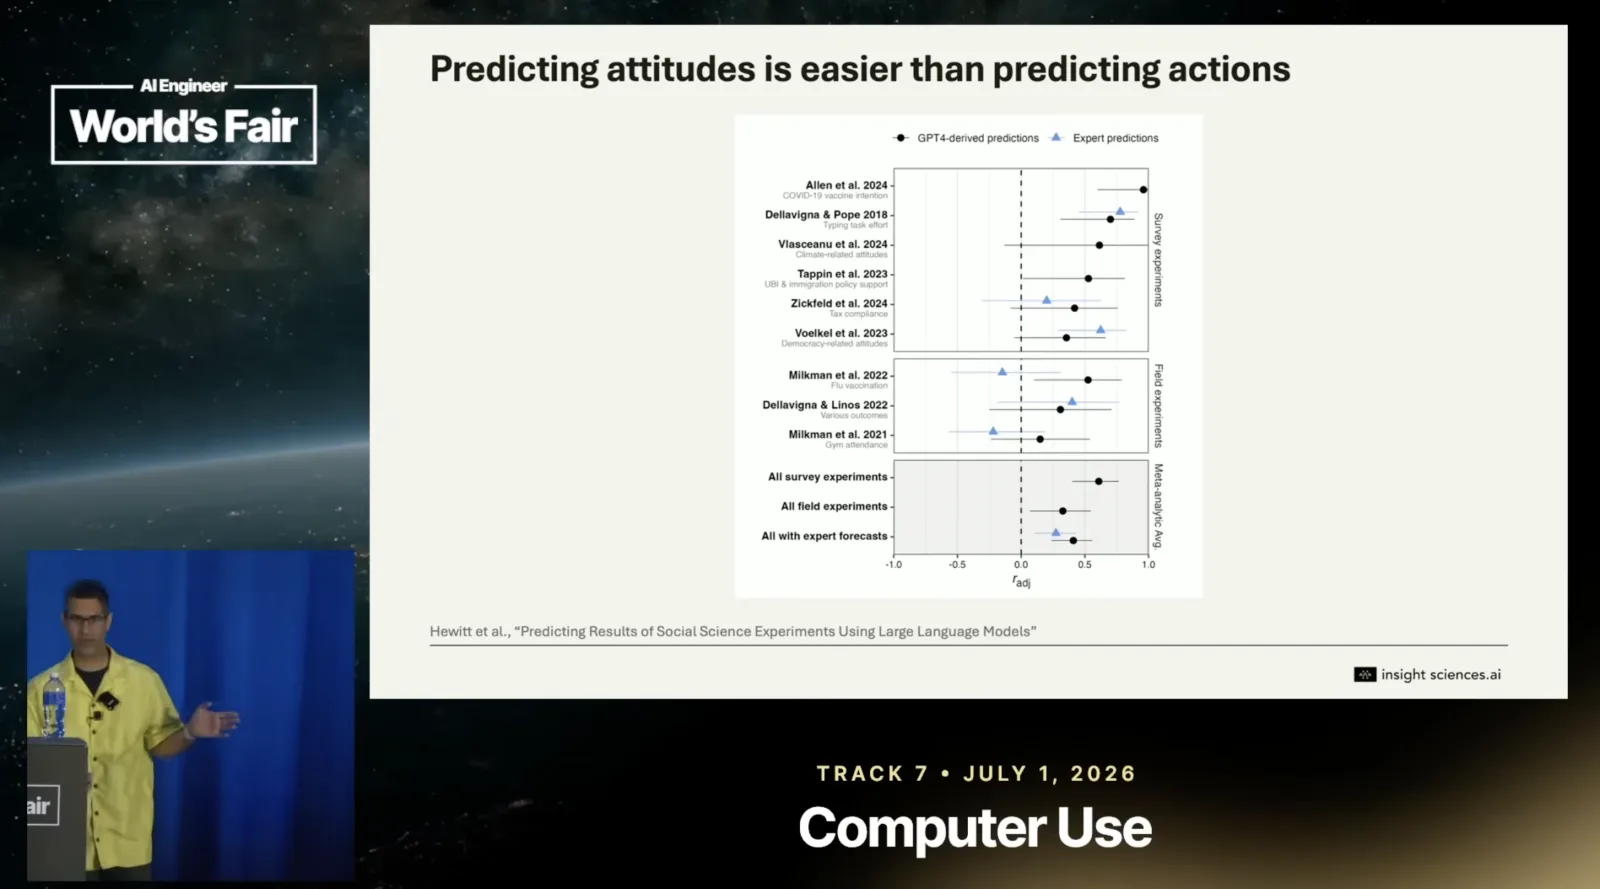
Anand는 LLM이 배운 건 사람들이 한 말(text, speech)이지 실제로 한 행동(action, behavior)이 아니라는 부분을 언급한다. 그래서 말로 드러나는 태도는 어느 정도 흉내 내도 실제 선택은 잘 맞히지 못한다. 강연은 LLM으로 실험 결과를 예측해본 Hewitt 등의 연구를 인용한다. 설문으로 태도(attitude)를 묻는 실험에서는 예측이 제법 맞지만, 실제 행동(behavior)을 관찰하는 현장 실험에서는 정확도가 눈에 띄게 떨어진다.
다른 연구에서도 행동 예측 관련해서 비슷한 결론을 제시한다. Kuric, Demcak & Krajcovic(2026)은 실제 UX 리서치에서 진행된 퍼스트 클릭 테스트 12건(참가자 3,431명)을 가져와, 사람들이 화면의 어디를 클릭할지 GPT가 맞힐 수 있는지 봤다. 전체 과제의 53%에서 합성 응답의 클릭 분포가 실제와 뚜렷하게 달랐다. 페르소나를 붙여도, 생각의 과정을 단계별로 쓰게 해도, 샘플링 값을 조정해도 정확도는 나아지지 않았다.
결론: 합성 유저는 실제 사람과 진행한 리서치 데이터로 뒷받침되어야 한다
지금까지 읽은 연구들이 공통으로 짚는 것은 실제 사람에게서 쌓은 리서치 데이터다. 합성 유저의 정확도를 높인 연구들의 전제도 같았다. Deep Binding에는 긴 인터뷰 기록이 필요했고, Park 등(2024)에는 2시간 인터뷰든 설문이든 실제 사람이 개인별로 자기보고(self-report)한 자료가 먼저 있어야 했다.
이러한 한계점 때문에 합성 유저가 사람 대상 리서치를 대체하기는 어렵다고 볼 수 있을 것 같다. 합성 유저를 제대로 쓰려면 세 가지 조건이 필요하다. (1) 리서치 데이터가 충분히 쌓인 분야일 것, (2) 합성 유저의 답을 그대로 받아들이지 않고 계속 의논하고 테스트해보는 방식으로 쓸 것, (3) 어떤 형태로든 합성 유저의 응답을 검증(validation)하는 절차를 같이 둘 것.
참고 문헌
- Gu, Chandrasegaran & Lloyd, "Synthetic users: insights from designers' interactions with persona-based chatbots" — AI EDAM, 2025. 합성 유저 개념을 제안한 논문
- Salminen, Amin, Jung & Jansen, "The Use of Large Language Models in HCI: A Critical Analysis of Synthetic Users" — Augmented Humans, 2025. 합성 유저가 확산되는 배경, 그에 따르는 위험, 사용 가능한 조건과 그렇지 않은 조건
- Park et al., "LLM Agents Grounded in Self-Reports Enable General-Purpose Simulation of Individuals" — 2024. 미국 성인 1,052명을 2주 뒤 재조사해 사람 쪽 노이즈를 먼저 잰 연구. GSS 기준 참가자 자기 일치율 79.53%, 인터뷰 기반 에이전트 원 정확도 65.67%, 정규화 정확도 0.83
- Romberg et al., "Hybrid Panels: Toward Human-AI Collaboration in Survey Research" — 2026. 사람 패널과 LLM을 같은 조사 안에 두고 조사 차수마다 보정하는 설계. 독일 1,201명 파일럿, 참여 의향 83% 대 69%
- Kuric, Demcak & Krajcovic, "What Would GPT Click: Practical Effects of Human-AI Behavioral Misalignment and the Cost of Synthetic Participants in User Experience" — 2026. 실무 퍼스트 클릭 테스트 12건(3,431명)으로 GPT의 클릭 예측을 검증. 과제의 53%에서 분포가 유의하게 달랐고, 페르소나·단계별 추론·샘플링 조정 모두 개선 효과 없음
- Kang et al., "Deep Binding of Language Model Virtual Personas" — 2025. 인터뷰 전사록을 배경 서사로 부여해 정치 성향 설문의 응답 분포 재현을 개선(Wasserstein 거리 기준 87%)
- DeepPersona: A Generative Engine for Scaling Deep Synthetic Personas — 2025. 수백 개의 구조화된 속성과 1MB 규모의 서술형 텍스트를 함께 쓰는 페르소나
- Rosala & Moran, "Synthetic Users: If Nothing Is Real, Everything Is Permitted" — Nielsen Norman Group, 2024. 실무 관점의 회의론. 비위 맞추기와 과도한 낙관, 우선순위 부재, 행동 데이터의 부재를 지적하고 허용 가능한 용도를 제한
- Anand, "Persona Engineering: A Field Guide to AI Synthetic Personas" — AI Engineer World's Fair, 2026. 일기예보 비유, 태도와 행동의 간극